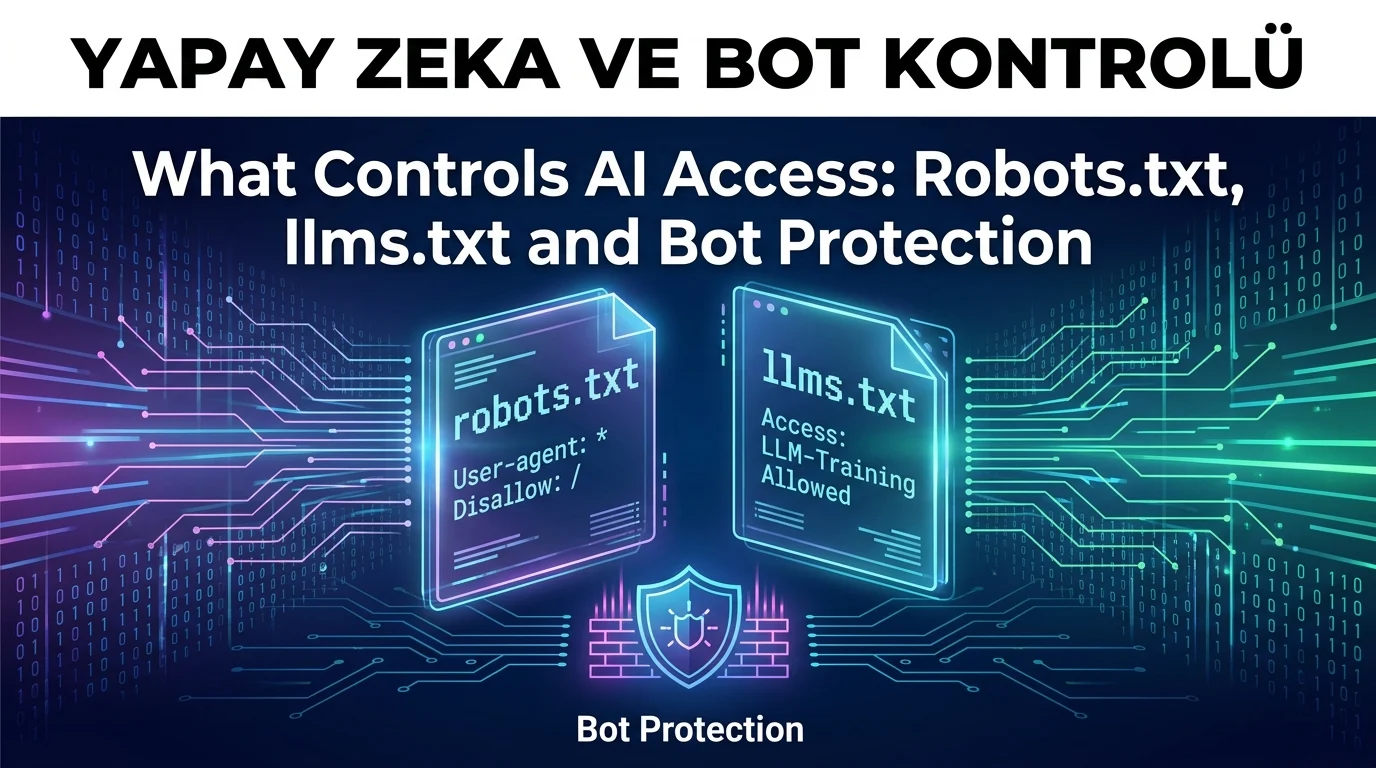

Yapay Zekâ Erişimi robots.txt, llms.txt ve bot korumasıyla nasıl yönetilir? Hangi katmanın tercih bildirdiğini, hangisinin gerçekten engellediğini öğrenin.
Sunucu kayıtlarında peş peşe gelen otomatik istekleri gördüğünüzde ilk refleks robots.txt dosyasını kapatmak ya da llms.txt eklemek olabilir. Fakat Yapay Zekâ Erişimi tek bir ayarla yönetilmiyor. Tarayıcıya tercih bildiren dosyalar, içeriği AI araçlarına daha düzenli sunan dosyalar ve isteği gerçekten durdurabilen güvenlik katmanları birbirinden farklı görevler üstleniyor.
Bu ayrım özellikle AI aramalarında görünür olmak isteyen siteler için önemli. Bir yandan içeriklerin eğitim amaçlı toplanmasını sınırlamak, diğer yandan ChatGPT, Claude veya Perplexity gibi sistemlerin arama sonuçlarında kaynak olarak görünmek isteyebilirsiniz. Yapay Zekâ Erişimi bu nedenle açık ya da kapalı biçiminde değil, hangi botun ne amaçla geldiğine göre ele alınmalı.
Altyapı seçimi de bu kontrolün ne kadar rahat uygulanacağını etkiler. Webflow ve WordPress Karşılaştırması: Hangisi Size Uygun içeriğinde yönetim esnekliği, dosya erişimi ve eklenti yapısı gibi farkları değerlendirirken bot trafiği tarafını da hesaba katmak gerekir. Özellikle robots.txt ve güvenlik katmanlarına müdahale imkânı, yoğun otomatik trafikte beklenenden daha önemli hale gelebilir.
Yapay Zekâ Erişimi Hangi Katmanda Kontrol Edilir?
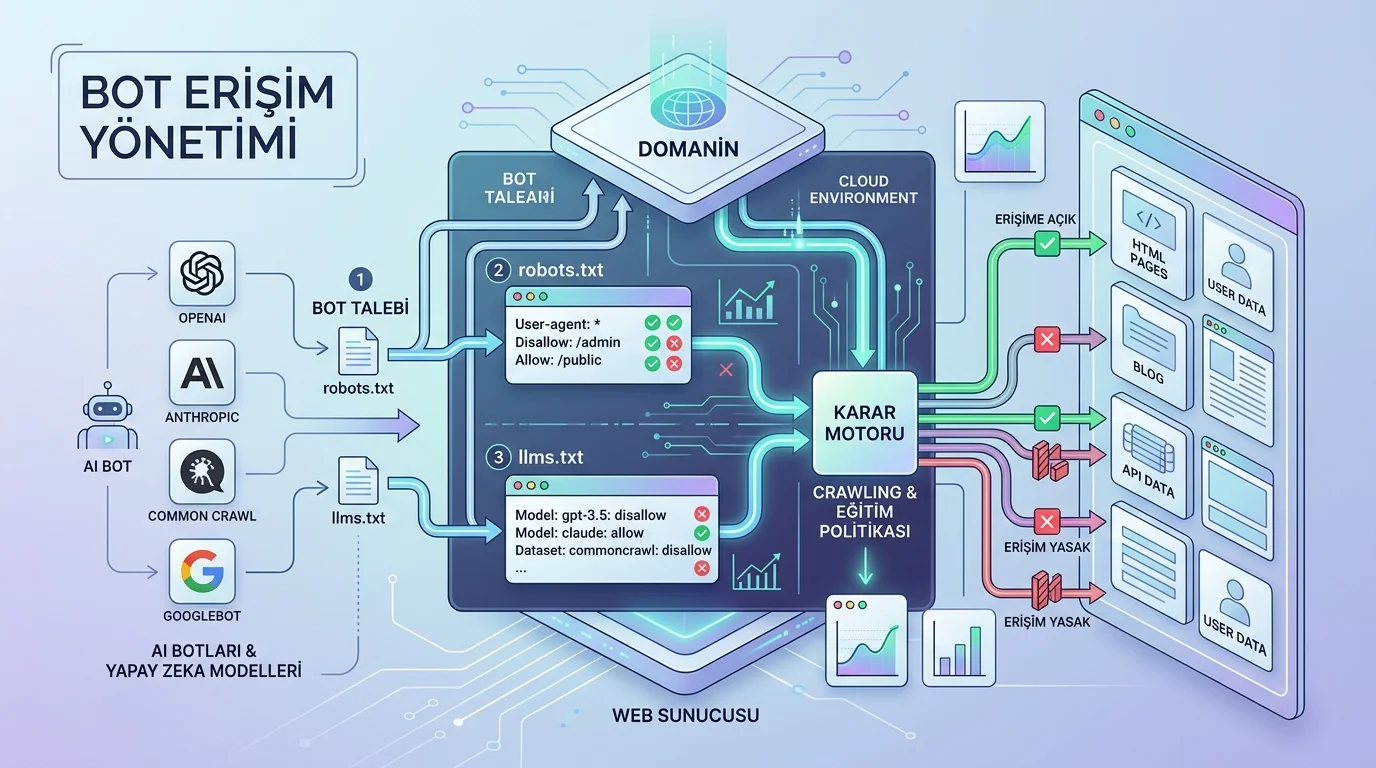
Yapay Zekâ Erişimi tek bir dosyayla kontrol edilmez. robots.txt, uyumlu tarayıcılara hangi alanları taramamalarını istediğinizi bildirir; teknik olarak erişimi kilitlemez. llms.txt içeriği AI araçları için düzenli biçimde listeler, izin yönetmez. Gerçek engelleme, sınırlama veya doğrulama ise WAF ve bot koruması gibi altyapı katmanlarında yapılır.
robots.txt bir tercih bildirir, erişim kilidi oluşturmaz
robots.txt, Robots Exclusion Protocol kapsamında tanımlanmış standart bir yapıdır. RFC 9309 açık biçimde bu kuralların erişim yetkilendirmesi olmadığını belirtir. Yani dosyaya Disallow yazmanız, sunucunun o isteği teknik olarak reddettiği anlamına gelmez; tarayıcının kurala uymasını beklersiniz.
Buradaki en kullanışlı nokta, eğitim ve arama botlarının ayrı ayrı yönetilebilmesidir. OpenAI, GPTBot için eğitimden hariç tutma tercihi sunarken OAI-SearchBot erişiminin ChatGPT arama sonuçlarında içeriklerin bulunabilmesi açısından önemli olduğunu belirtiyor. Anthropic de ClaudeBot, Claude-SearchBot ve Claude-User için ayrı roller tanımlıyor.
Örneğin eğitim amaçlı taramayı kapatıp arama görünürlüğünü açık bırakmak istiyorsanız şu yapı kullanılabilir:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /
Google tarafında küçük ama önemli bir ayrıntı var. Google-Extended ayrı bir HTTP user-agent olarak çalışmıyor; robots.txt içinde kontrol amacıyla kullanılan bir belirteç. Google, bu ayarın normal Google Arama dizinine dahil edilmeyi veya sıralama sinyalini etkilemediğini belirtiyor.
Editör notu: İncelediğim güncel sağlayıcı belgelerinde en kolay karıştırılan noktanın bot adı değil, botun görevi olduğunu fark ettim. Aynı şirketin eğitim, arama ve kullanıcı isteğiyle sayfa getiren ayrı tarayıcıları bulunabiliyor. Bu nedenle tüm AI botlarını tek User-agent kuralıyla kapatmak, istenmeyen eğitim trafiğini azaltırken arama görünürlüğünü de gereksiz yere kesebilir.
llms.txt yapay zekâ botlarını engeller mi?
Hayır. llms.txt bir izin dosyası değildir. Markdown biçimindeki bu dosya, önemli sayfaları ve açıklamalarını daha düzenli bir içerik haritası halinde sunmayı amaçlar. İçinde kullanıcı aracısı hedefleme, Allow veya Disallow benzeri bir erişim mekanizması bulunmaz. Bu yüzden Yapay Zekâ Erişimi üzerinde doğrudan engelleyici etkisi yoktur.
2026 itibarıyla Google Search, llms.txt dosyasını özel bir sıralama veya AI görünürlük sinyali olarak kullanmadığını açıkça belirtiyor. Dosya bazı geliştirici araçları ve ajanlar için okunabilir bir içerik dizini olarak işe yarayabilir, fakat yoğun taramayı azaltmak için güvenlik katmanı yerine konulmamalıdır.
Bot Koruması Neden Farklı Çalışır?
Bot Koruması, robots.txt gibi istekte bulunan tarayıcının iyi niyetine bağlı değildir. WAF ve bot yönetimi çözümleri gelen isteği altyapı seviyesinde değerlendirerek belirli tarayıcıları engelleyebilir, doğrulama uygulayabilir veya trafik kurallarına göre sınırlayabilir. Cloudflare, robots.txt uyumunun gönüllü olduğunu ve gerçek engelleme gerektiğinde AI Crawl Control gibi yaptırım uygulayan katmanların kullanılabileceğini açıkça ayırıyor.
Bu yaklaşım Yapay Zekâ Erişimi için daha dengeli bir politika kurmayı sağlar. Arama ve cevap motorlarının sitenizi kaynak olarak kullanmasına izin verirken eğitim botlarını sınırlayabilir, aynı zamanda aşırı istek gönderen otomatik trafiği güvenlik kurallarıyla kontrol altında tutabilirsiniz. WooCommerce gibi çok sayıda filtre ve parametreli URL üreten yapılarda bu ayrım daha da önem kazanır; robots.txt tarama tercihini bildirir, altyapı koruması ise kurala uymayan yoğun isteğe karşı gerçek işlem yapar.
Bilgi tarafı netleştiğinde, sorunun dosya düzenleme mi yoksa sunucu ve güvenlik yapılandırması mı olduğunu ayırmak daha kolay olur. Bu tür teknik işlemlerde uzaktan destek gerekirse 11858, 2011 yılından bu yana Türkiye genelinde 7/24 hizmet veriyor; bilgisayar, akıllı TV, sosyal medya ve modem kurulumları gibi farklı alanlarda destek sağlıyor. TeamViewer ve AnyDesk gibi lisanslı yazılımlar üzerinden güvenli bağlantı sunan hizmet, dakika bazlı ücretlendirme, yüzde 95 memnuniyet oranı ve 500.000’den fazla başarılı işlem deneyimiyle uzman ekip tarafından yürütülüyor.
Bir platform değişikliği planlanıyorsa erişim politikalarının yeni altyapıda da gözden geçirilmesi gerekir. Joomla’dan WordPress’e Geçiş İçin 9 Uygulanabilir Adım içeriğini değerlendirirken robots.txt ve bot koruması yapılandırmalarını da geçiş planına dahil etmek, yeni sistemin nasıl taranacağını baştan belirlemeyi kolaylaştırır.
Yapay Zekâ Erişimi için en sağlıklı yaklaşım, görünürlük ile güvenliği aynı ayar üzerinden çözmeye çalışmamaktır. Hangi tarayıcının eğitim, arama veya kullanıcı isteği amacıyla geldiğini ayırdığınızda daha kontrollü karar verebilirsiniz. Siz sitenizde AI tarayıcılarını tamamen sınırlamayı mı, yoksa yalnızca eğitim botlarını kapatmayı mı tercih ediyorsunuz? Görüşünüzü yorumlarda paylaşabilirsiniz.