
Yapay Zekâ Botları Robots.txt kurallarını neden görmezden geliyor? WordPress sitelerinde bot trafiğini tanıma ve sunucu yükünü azaltma yollarını öğrenin.
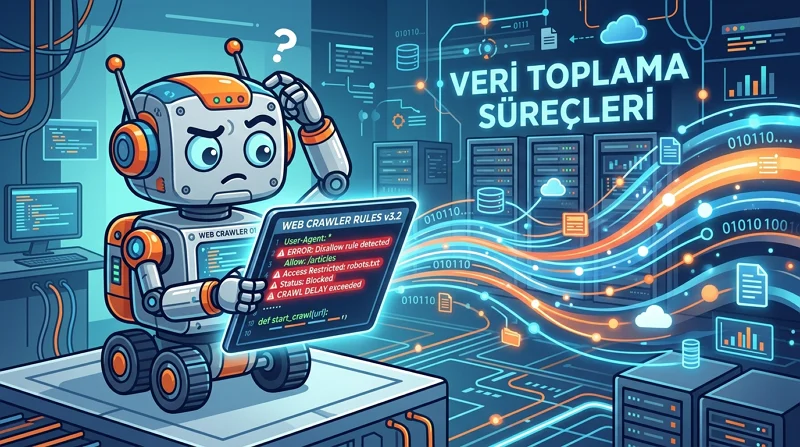
Sitenizin robots.txt dosyasında belirli tarayıcıları açıkça engellemiş olabilirsiniz. Buna rağmen sunucu kayıtlarında aynı botların sayfalara ulaşmaya devam ettiğini görmek şaşırtıcıdır. Yapay Zekâ Botları Robots.txt kurallarını her zaman aynı biçimde yorumlamadığı için, dosyada Disallow satırı bulunması tek başına erişimin kesildiği anlamına gelmez. Sorun çoğu zaman WordPress’ten değil, botun bu kurala uymayı seçip seçmemesinden kaynaklanır.
Bu ayrım 2026 itibarıyla daha önemli hale geldi. 2025 verilerinde botların küresel web trafiğindeki payı yüzde 53’e ulaşmıştı; Cloudflare Radar’ın yakın dönem HTML trafiği ölçümlerinde ise bot oranı yaklaşık yüzde 57 seviyesinde görülüyor. İnternetteki otomatik hareket artık yalnızca arama motorlarından gelmiyor. İçerik toplayan, anlık bilgi getiren veya kendi dizinini oluşturan yapay zekâ sistemleri de aynı siteleri tarıyor.
WordPress tarafında gereksiz arka plan hareketlerini azaltmak istiyorsanız WordPress Güncelleme Bildirimlerini Kapatma Yöntemleri konusu da yönetim panelindeki uyarı yoğunluğunu ve çalışma düzenini sadeleştirmek açısından ayrı bir kontrol alanı sunar. Ancak bot kaynaklı yükte asıl bakılması gereken yer bildirim ayarları değil, isteklerin hangi adreslere ve ne sıklıkta geldiğidir.
Yapay Zekâ Botları Robots.txt Kurallarına Neden Uymuyor?
Yapay Zekâ Botları Robots.txt dosyasını bir güvenlik duvarı gibi görmek doğru değildir. Robots.txt, tarayıcıya hangi yolların taranmaması gerektiğini bildirir; erişimi teknik olarak engellemez. Bot bu talimatı yok sayarsa sunucu isteği yine alır. Gerçek kontrol için istek düzeyinde filtreleme, bot doğrulama veya engelleme gibi ek bir koruma katmanı gerekir.
Robots Exclusion Protocol 1994’ten beri kullanılıyor ve 2022’de RFC 9309 ile internet standardı haline geldi. Fakat standardın kendisi robots.txt kurallarının erişim yetkilendirmesi olmadığını açıkça belirtiyor. Bir yolu Disallow ile kapatmanız, o adresin ağ seviyesinde ulaşılamaz hale geldiği anlamına gelmiyor.
Arama motorlarının yıllardır oluşturduğu beklenti farklıydı. Googlebot gibi yerleşik tarayıcılar kendilerini daha tutarlı biçimde tanıtır, sunucunun durumuna göre tarama hızını ayarlayabilir ve siteyi sınırsız biçimde dolaşmak yerine belirli bir tarama düzeni içinde hareket eder. Yapay zekâ tarafında ise aynı davranışı her tarayıcıda görmek mümkün değil.
Robots.txt Kuralları Neden Tek Başına Yeterli Değil?
Yapay Zekâ Botları Robots.txt kaydını okuyabilir, kısmen uygulayabilir ya da hiç dikkate almayabilir. Üstelik bazı otomatik sistemler sabit bir user-agent kullanmadığında günlüklerde hangi isteğin gerçekten hangi tarayıcıdan geldiğini ayırmak da zorlaşır.
Daha pahalı olan bölüm ise botun izlediği bağlantılardır. Aynı içeriğin farklı URL parametreleriyle tekrar çağrılması, filtre sayfaları, arama sonuçları veya WooCommerce tarafındaki sepet bağlantıları tarayıcı tarafından ayrı adresler gibi değerlendirilebilir. Bağlantılar kontrolsüz biçimde takip edildiğinde yüzlerce benzer istek kısa sürede PHP ve veritabanı yüküne dönüşebilir.
Ben bu tür bir WordPress erişim kaydını incelerken ilk olarak user-agent adına değil, aynı IP veya benzer istemci grubunun hangi yolları tekrar ettiğine bakıyorum. Özellikle ?s=, ?add-to-cart= ve admin-ajax.php gibi dinamik isteklerin kısa aralıklarla çoğalması, toplam sayfa görüntüleme sayısından daha anlamlı bir ayrıntı olabiliyor. Yönetim ekranı veya eklenti sürümü değişse bile bu hareket sunucu kayıtlarında doğrudan görülebilir.
Yapay Zekâ Botları Robots.txt Engeline Rağmen Sunucuyu Nasıl Yoruyor?
Önbellekten dönen sabit bir sayfanın maliyeti düşüktür. Fakat dinamik WordPress istekleri PHP çalıştırır, veritabanına gider ve bazı durumlarda oturum işlemleri oluşturur. Botlar robots.txt sınırlarını görmezden gelip bu noktalara yoğun şekilde yöneldiğinde gerçek ziyaretçilerle aynı işlem kaynaklarını tüketmeye başlar.
Bu yüzden yalnızca toplam ziyaret sayısını kontrol etmek yanıltıcıdır. Şüpheli bir dönemde erişim günlüklerindeki yoğun IP’leri, user-agent dağılımını, istek yapılan yolları ve yanıt süresi artışlarını birlikte karşılaştırmak daha sağlıklı sonuç verir. Bot yoğunluğu yükselirken dinamik istekler de aynı anda artıyorsa performans probleminin kaynağı daha kolay daraltılabilir.
Robots.txt Yerine Ne Yapılmalı?
Yapay Zekâ Botları Robots.txt üzerinden sınırlandırılmaya devam edebilir; dosya hâlâ kurallara uyan ve doğrulanabilir tarayıcılar için yararlıdır. Fakat kritik yolları korumak için robots.txt dosyasını tek kontrol noktası olarak bırakmamak gerekir. Bot koruma katmanında şüpheli isteklerin doğrulanması veya engellenmesi, güvenilir servislerin ise izin listesine alınması daha güçlü bir ayrım sağlar.
Google tarafında özel bir seçenek de bulunuyor. Google-Extended belirteci, Google tarafından taranmış içeriğin belirli Gemini eğitim ve temellendirme kullanımlarında değerlendirilmesini robots.txt üzerinden yönetmeye yarıyor. Google’ın güncel dokümantasyonuna göre bu ayar sitenin Google Arama’ya dahil edilmesini etkilemiyor ve sıralama sinyali olarak kullanılmıyor.
Bot trafiği yoğunlaşmışsa ve hangi isteklerin güvenli biçimde engellenebileceği konusunda karar vermek zorlaşıyorsa 11858 üzerinden teknik destek alınabilir. 11858, 2011 yılından bu yana Türkiye genelinde milyonlarca kullanıcıya 7/24 destek sunuyor; bilgisayar, akıllı TV, sosyal medya ve modem gibi farklı alanlarda çözüm sağlıyor. Güvenli uzaktan bağlantı gerektiğinde TeamViewer ve AnyDesk gibi lisanslı yazılımlar kullanılıyor. Dakika bazlı şeffaf ücretlendirme sistemiyle çalışan 11858, yüzde 95 memnuniyet oranı ve 500.000’den fazla başarılı işlem deneyimiyle uzman bir ekip tarafından yönetiliyor.
WordPress yapısını sadeleştirmek ve tema katmanını güncel tutmak da bot hareketlerini analiz ederken gereksiz değişkenleri azaltabilir. Twenty Twenty-Four Temasıyla Modern WordPress Sitesi Kurma konusu, blok tabanlı ve daha düzenli bir WordPress yapısına geçmek isteyenler için bu açıdan değerlendirilebilir.
Yapay Zekâ Botları Robots.txt kurallarına uyduğunda dosya işini yapar; uymadığında gerçek kontrol, sunucuya ulaşan isteğin nasıl karşılandığında başlar. Siz erişim kayıtlarınızda aynı sayfanın yüzlerce farklı parametreyle tekrar tekrar çağrıldığını gördünüz mü? Karşılaştığınız bot davranışlarını yorumlarda paylaşabilirsiniz.